JEV AI: El Modelo ‘Sistema 1’ | 193x Más Rápido que los LLM | Análisis Completo
Durante los últimos años, los modelos de lenguaje a gran escala (LLMs) como GPT-4 o Claude han demostrado habilidades extraordinarias para escribir texto, resumir documentos y razonar paso a paso. Sin embargo, presentan una importante limitación técnica para el uso intensivo en producción: fueron diseñados para la interacción humana y el texto generativo, no para la ejecución rápida de software.
Cada vez que un sistema de software o un agente de inteligencia artificial necesita tomar una decisión simple —como clasificar un correo, enrutar una solicitud de soporte o auditar una llamada de herramienta (tool call)—, un LLM convencional procesa la respuesta token por token de manera auto-regresiva. Esto genera una latencia de varios segundos y costos acumulativos elevados a gran escala.
Para resolver este cuello de botella nace JEV, desarrollado por Typesafe AI. Fundada por Diego Almeida (coautor de InstructGPT y exinvestigador de OpenAI) y respaldada por una ronda semilla de $40 millones liderada por DCVC, Typesafe AI propone un paradigma completamente diferente: abandonar la generación de texto para enfocarse exclusivamente en decisiones estructuradas ultra rápidas.
¿Qué es JEV y cómo funciona el modelo ‘Sistema 1’?
El concepto central de JEV está inspirado en la teoría de los dos sistemas de pensamiento propuesta por el premio Nobel Daniel Kahneman en su libro Thinking, Fast and Slow:
- Sistema 2 (Lento y Reflexivo): Representado por los LLMs tradicionales. Razonan paso a paso, consumen tiempo de procesamiento y generan explicaciones detalladas en lenguaje natural.
- Sistema 1 (Rápido e Intuitivo): Representado por JEV. Ejecuta juicios instantáneos y directos tipo «corazonada» basada en contexto, entregando un resultado estructurado en milisegundos .
+-------------------------------------------------------------------------+
|                        ARQUITECTURA DE DECISIÓN                         |
+-------------------------------------------------------------------------+
| LLM Tradicional (Sistema 2):                                            |
| Estado / Prompt ---> Razonamiento auto-regresivo ---> Texto / Tokens    |
|                      (Latencia: 3s - 5min)                              |
+-------------------------------------------------------------------------+
| JEV AI (Sistema 1):                                                     |
| Estado + Pregunta ---> Evaluación en Paralelo ---> JSON Estructurado    |
| (JSON / Contexto)      (RLCD)                     (Latencia: 70-500ms) |
+-------------------------------------------------------------------------+
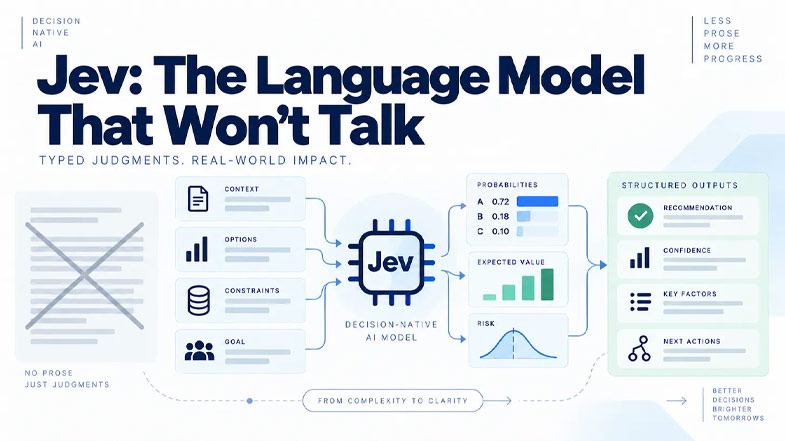
La regla de oro: JEV no escribe ni una sola palabra
JEV no puede escribir oraciones ni redactar código. En su lugar, recibe como entrada un estado del programa (como un ticket de soporte, datos de sesión o logs de seguridad) y un conjunto de preguntas tipadas definidas por el desarrollador .
JEV evalúa todas las preguntas en una sola pasada paralela (sin ciclo auto-regresivo), devolviendo directamente un objeto JSON con tipos de datos garantizados y un nivel de probabilidad o confianza asociado.
Tipos de Consultas Primarias en JEV
Al interactuar con la API de JEV, los desarrolladores pueden formular tres tipos de preguntas estructuradas:
| Tipo de Pregunta | Descripción | Ejemplo de Uso |
|---|---|---|
Choice | Selecciona la opción más adecuada de una lista predefinida (hasta 255 opciones) . | Enrutamiento de tickets de soporte (billing, technical, sales). |
Score | Otorga una puntuación o gradiente sobre una escala predeterminada. | Evaluar el nivel de frustración o urgencia de un usuario. |
Null | Devuelve una probabilidad de verdadero/falso (booleano con confianza). | ¿La solicitud contiene un intento de jailbreak o amenaza de seguridad?. |
Rendimiento, Velocidad y Modelo de Precios: Las Cifras Clave
Las métricas publicadas por Typesafe AI y validadas por los primeros desarrolladores muestran ventajas competitivas sustanciales frente a los modelos de frontera tradicionales:
- Velocidad de Respuesta: De 70 a 500 milisegundos por consulta (con un promedio de 150 a 185 ms), lo que representa una aceleración de 40x a 193x respecto a modelos como GPT-5.6 o Claude.
- Costo de Entrada: $0.042 por millón de tokens ($4.2 centavos por millón de tokens de entrada).
- Tokens de Salida GRATUITOS: Dado que JEV no genera cadenas de texto auto-regresivas, los tokens de salida cuestan exactamente $0.
- Reducción de Costos Totales: Entre 20x y 444x más económico por flujo de trabajo en comparación con modelos de frontera tradicionales.
El Método RLCD (Reinforcement Learning for Calibrated Decisions)
A diferencia de los LLM convencionales que se entrenan con alineación basada en preferencias humanas (RLHF), JEV utiliza RLCD. Este método recompensa al modelo cuando sus estimaciones de probabilidad reflejan la certidumbre real del resultado, logrando que sus puntuaciones de confianza sean honestas y calibradas.
Casos de Uso Prácticos: Dónde Brilla JEV
El propósito de JEV no es reemplazar a los LLMs, sino actuar como un orquestador y filtro de alta velocidad en arquitecturas híbridas de software:
1. Enrutamiento de Modelos y Guardarraíles (Model Routing)
En lugar de enviar cada petición directamente a un modelo costoso como GPT-4 o Claude Opus, JEV puede evaluar en milisegundos cuál es la complejidad del problema y dirigir la consulta al modelo más eficiente.
2. Triaje de Soporte y Clasificación de Emails
Empresas como Vercel sustituyeron modelos ligeros (como Gemini Flash) por JEV para tareas de clasificación masiva, logrando respuestas 6 veces más rápidas y superando los límites de precisión del eval. Pruebas de desarrolladores independientes demostraron la capacidad de clasificar y priorizar miles de correos en pocos segundos.
3. Agentes de Código y Llamadas a Herramientas (MCP & Tool Calling)
Al ejecutar agentes de software, JEV permite decidir qué herramienta (tool call) debe invocarse en cada paso sin demoras perceptibles y sin riesgo de invocar funciones inexistentes.
4. Automatización en Tiempo Real y Videojuegos
Demostraciones públicas muestran a JEV ejecutándose en tiempo real dentro del videojuego Doom, realizando cerca de 10 decisiones por segundo con un costo aproximado de $7 por hora de juego continuo, o resolviendo el reto de navegabilidad Wiki Racing en solo 1.7 segundos.
Benchmarks y Limitaciones: ¿Qué Hay Detrás de las Cifras?
A pesar de sus impresionantes ventajas en latencia y costo, los análisis técnicos y pruebas de terceros destacan aspectos clave a tener en cuenta:
- Garantía de Esquema vs. Precisión de Respuesta: JEV ofrece un 0% de error de esquema por diseño (jamás devolverá una categoría que no le haya sido otorgada). Sin embargo, eso no significa cero errores lógicos: el modelo puede elegir la opción incorrecta si la lógica de entrada es compleja o ambigua.
- Resultados en Evaluaciones Comparativas: En el promedio de los 4 flujos de trabajo de Typesafe, JEV alcanzó un 67.8% de coincidencia con las respuestas de referencia (comparable al 67.9% de GPT-5.6 Terra, aunque por debajo del 74.1% de GPT-5.6 Soul).
- Límites Técnicos: Presupuesto de contexto de entrada limitado a 32,000 tokens y un límite de 255 opciones por consulta
Choice.
El Significado del Nombre: La Paradoja de Jevons
El nombre del modelo rinde homenaje a William Stanley Jevons, economista del siglo XIX que formuló la famosa Paradoja de Jevons: al aumentar la eficiencia en el uso de un recurso (como el carbón en las máquinas de vapor), el consumo total de ese recurso aumenta en lugar de disminuir.
Typesafe AI prevé que ocurrirá lo mismo con la inteligencia artificial: al reducir el costo y el tiempo de una decisión a una fracción de centavo y de segundo, los desarrolladores integrarán evaluaciones inteligentes en lugares donde antes jamás habrían utilizado un LLM tradicional.


