BERT (Bidirectional Encoder Representations from Transformers)
BERT (Bidirectional Encoder Representations from Transformers, traducido como «representaciones de codificadores bidireccionales basadas en transformadores») es una familia fundacional de modelos de lenguaje basada en la arquitectura Transformer encoder. Publicado por investigadores de Google en 2018 y presentado en NAACL en 2019, introdujo una estrategia de preentrenamiento bidireccional profundo que cambió el diseño de sistemas para clasificación de textos, reconocimiento de entidades, respuesta extractiva a preguntas y otras tareas de procesamiento del lenguaje natural (NLP).
Este artículo analiza BERT desde una perspectiva de ingeniería: arquitectura, formulación matemática, tokenización, objetivos de entrenamiento, costos computacionales, ajuste fino y evaluación. También compara las principales versiones de BERT y sus derivados, con especial atención a los modelos BERT en español, como BETO, MarIA y BERTIN.
Precisión terminológica: no existe un catálogo cerrado de «todas las versiones de BERT». Hay configuraciones oficiales del modelo original, arquitecturas derivadas y checkpoints entrenados en distintos idiomas o dominios. Una versión en español no implica traducir los parámetros de un BERT inglés: normalmente requiere preentrenamiento específico o adaptación de un modelo multilingüe.
¿Qué es BERT en procesamiento del lenguaje natural?
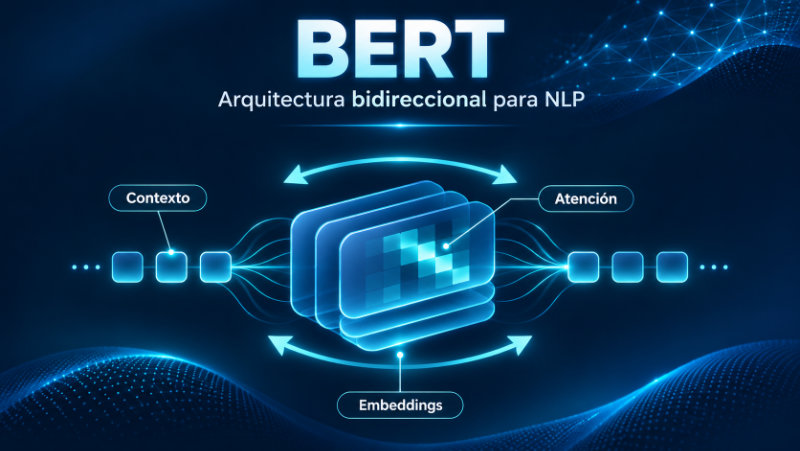
BERT es un codificador contextual de secuencias: transforma una entrada tokenizada en una matriz de representaciones vectoriales, una por posición. A diferencia de los modelos autorregresivos que predicen el siguiente token usando exclusivamente el contexto anterior, un codificador BERT estándar permite que cada posición atienda tanto a los tokens previos como a los posteriores dentro de la secuencia de entrada.
La distinción es importante. «Bidireccional» no significa procesar dos veces el texto con redes recurrentes independientes. Significa que el mecanismo de self-attention no aplica una máscara causal de futuro: cada token puede construir su representación utilizando el contexto disponible en ambas direcciones.
Considérese la frase «El banco rechazó el crédito» frente a «Me senté en el banco del parque». La representación contextual de «banco» cambia según las otras palabras de la secuencia. BERT aprende ese comportamiento mediante preentrenamiento autosupervisado, sin necesitar una etiqueta semántica explícita para cada aparición.
El trabajo original es BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding, de Jacob Devlin, Ming-Wei Chang, Kenton Lee y Kristina Toutanova.
Arquitectura BERT: el Transformer encoder explicado técnicamente
1. Representación de entrada y embeddings
En BERT original, la entrada para cada posición combina tres representaciones entrenables:
- Token embedding: representación del identificador del token generado por WordPiece.
- Position embedding: información sobre la posición absoluta dentro de la secuencia.
- Segment embedding: identificación del segmento A o B, también denominado token type embedding.
La suma de estos embeddings se normaliza y regulariza antes de ingresar al primer bloque Transformer. En una tarea con dos segmentos, el formato típico de BERT es [CLS] texto A [SEP] texto B [SEP]. El token [CLS] suele alimentar una cabeza de clasificación; [SEP] separa segmentos; y [PAD] completa lotes de longitud desigual. No todas las variantes posteriores conservan exactamente este esquema.
2. Self-attention y atención multicabezal
Dada una matriz de estados ocultos X, cada cabeza proyecta consultas, claves y valores mediante matrices aprendidas: Q = XW_Q, K = XW_K y V = XW_V. La atención escalada se calcula como:
Attention(Q, K, V) = softmax((Q K^T) / sqrt(d_k) + M) VDonde d_k es la dimensión de las claves y M representa la máscara aditiva. En BERT estándar, esta máscara excluye el relleno, pero no impide acceder a posiciones futuras. Las salidas de varias cabezas se concatenan y se proyectan nuevamente. Esto permite aprender dependencias sintácticas, referencias y relaciones semánticas de distinto tipo.
Cada bloque encoder incluye atención multicabezal, conexiones residuales, normalización y una red feed-forward aplicada por posición. El cómputo de la matriz de atención completa crece aproximadamente de forma cuadrática con la longitud de secuencia: O(n^2) para las interacciones entre posiciones. Por esa razón, los documentos extensos requieren fragmentación o arquitecturas de atención más eficientes.
3. Salidas y cabezas de tarea
Para una secuencia de n tokens y dimensión oculta H, el encoder produce una matriz de tamaño aproximado n × H. Sobre esa salida pueden agregarse diferentes cabezas:
- Clasificación de secuencias: representación agregada, frecuentemente asociada a
[CLS], seguida de una capa de clasificación. - Clasificación por token: predicción de una etiqueta por posición para NER, etiquetado morfosintáctico o detección de información personal.
- Respuesta extractiva a preguntas: puntuaciones para seleccionar las posiciones inicial y final de una respuesta presente en el contexto.
- Similitud semántica: embeddings obtenidos mediante una estrategia de pooling y, preferentemente, un entrenamiento contrastivo específico para recuperación.
Es un error suponer que el vector [CLS] de cualquier BERT preentrenado produce automáticamente el mejor embedding para búsqueda semántica. Para ese uso suelen funcionar mejor modelos bi-encoder o sentence-transformers ajustados con ejemplos positivos y negativos.
Cómo se entrena BERT: MLM, NSP y enmascaramiento de palabras completas
Masked Language Modeling (MLM): modelado de lenguaje enmascarado
El objetivo principal del BERT original es reconstruir tokens seleccionados a partir de su contexto. En el procedimiento clásico se selecciona aproximadamente el 15 % de las posiciones WordPiece para calcular la pérdida. De las posiciones seleccionadas, el 80 % se reemplaza por [MASK], el 10 % por un token aleatorio y el 10 % permanece sin cambios. La pérdida se calcula sobre los tokens elegidos, independientemente de la modificación aplicada a la entrada.
L_MLM = -(1 / |S|) * sum(log P(x_i | x_corrupta), para i en S)Aquí S es el conjunto de posiciones elegidas para predicción. Este procedimiento permite que el modelo aprenda dependencias contextuales bidireccionales. El símbolo [MASK] es una herramienta de preentrenamiento, no una palabra que normalmente aparezca en textos reales durante inferencia.
Next Sentence Prediction (NSP): predicción de la siguiente oración
El modelo original incorpora además una clasificación binaria sobre dos segmentos: determinar si el segmento B continúa al A en el corpus o si fue seleccionado aleatoriamente. La función objetivo combina la pérdida MLM con la pérdida NSP. Posteriormente, RoBERTa mostró que eliminar NSP, junto con otros cambios en los datos y el entrenamiento, podía mejorar resultados; por lo tanto, NSP no es un requisito universal de los encoders derivados de BERT.
Whole Word Masking (WWM): enmascaramiento de palabras completas
WordPiece puede dividir una palabra en varios subtokens. Con WWM se seleccionan grupos de subtokens correspondientes a palabras enteras para enmascararlos conjuntamente. Este cambio evita que la predicción dependa de fragmentos visibles de la misma palabra y se utiliza, entre otros casos, en los checkpoints BETO.
Preentrenamiento, fine-tuning y adaptación de dominio no son equivalentes: preentrenar construye representaciones generales; el fine-tuning supervisado ajusta el modelo a una tarea con etiquetas; y el preentrenamiento adicional sobre documentos específicos del dominio, conocido como domain-adaptive pretraining (DAPT), permite actualizar las representaciones antes del ajuste final.
Versiones originales de BERT: Base, Large, cased, uncased y multilingüe
Las configuraciones oficiales más conocidas difieren en profundidad, dimensionalidad, cantidad de cabezas y tratamiento de mayúsculas. En la tabla, los parámetros son valores aproximados de referencia para los checkpoints originales en inglés.
| Versión | Capas | Dimensión oculta | Cabezas | Parámetros aproximados | Características |
|---|---|---|---|---|---|
| BERT-Base | 12 | 768 | 12 | 110 millones | Configuración de referencia para ajuste fino. |
| BERT-Large | 24 | 1024 | 16 | 340 millones | Mayor capacidad y costo computacional. |
| BERT cased | Base o Large | Según tamaño | Según tamaño | Según checkpoint | Conserva información de mayúsculas y minúsculas. |
| BERT uncased | Base o Large | Según tamaño | Según tamaño | Según checkpoint | Normaliza el uso de mayúsculas según su tokenizador. |
| BERT con WWM | Base o Large | Según tamaño | Según tamaño | Según checkpoint | Enmascara conjuntamente subtokens de una palabra. |
| mBERT | 12 en su versión Base conocida | 768 | 12 | Depende del vocabulario | Modelo multilingüe con cobertura de 104 idiomas, incluido el español. |
En BERT original, la longitud máxima habitual es de 512 posiciones, contando los tokens especiales; no equivale a 512 palabras. Cased significa «sensible a mayúsculas» y uncased «sin distinción de mayúsculas». Para reconocimiento de nombres propios, siglas y entidades institucionales suele ser pertinente evaluar primero un modelo cased, sin asumir que siempre superará al uncased.
Checkpoints de referencia: bert-base-cased, bert-base-uncased y bert-base-multilingual-cased.
Variantes de BERT y modelos derivados: comparación técnica
Los nombres siguientes se conservan como identificadores de investigación, acompañados de una descripción en español. No todas estas arquitecturas son «versiones oficiales de Google BERT»: algunas cambian el objetivo de preentrenamiento, otras comprimen el encoder y otras modifican el patrón de atención.
| Modelo | Nombre o interpretación en español | Innovación técnica principal | Cuándo considerarlo |
|---|---|---|---|
| RoBERTa | BERT con preentrenamiento optimizado de manera robusta | Enmascaramiento dinámico, eliminación de NSP y entrenamiento con más datos y lotes mayores. | Clasificación y extracción con encoder robusto. |
| ALBERT | BERT ligero | Factoriza embeddings, comparte parámetros entre capas y utiliza predicción del orden de segmentos. | Reducir parámetros sin equiparar necesariamente ahorro de memoria a menor latencia. |
| DistilBERT | BERT destilado | Transfiere conocimiento de un modelo profesor a un alumno más pequeño. | Inferencia con restricciones de memoria y latencia. |
| ELECTRA | Preentrenamiento discriminativo de codificadores | Detección de tokens sustituidos por muestras de un generador, en lugar de reconstruir únicamente tokens enmascarados. | Preentrenamiento más eficiente en muestras. |
| DeBERTa | BERT con decodificación mejorada y atención desacoplada | Separa información de contenido y posición dentro de la atención. | Comprensión de texto con atención posicional más expresiva. |
| DeBERTaV3 | Tercera evolución de DeBERTa | Integra detección de tokens reemplazados y compartición de embeddings con gradientes desacoplados. | Alternativa fuerte para clasificación y comprensión. |
| SpanBERT | BERT orientado a fragmentos de texto | Enmascara intervalos contiguos y aprende representaciones de sus límites. | Extracción de fragmentos, correferencias y respuestas. |
| MobileBERT | BERT compacto para dispositivos | Arquitectura comprimida y destilación orientada a ejecución con recursos limitados. | Despliegues móviles o periféricos. |
| TinyBERT | BERT reducido mediante destilación | Destila representaciones y relaciones de atención en modelos más pequeños. | Servicios con presupuestos de cómputo estrictos. |
| BioBERT | BERT biomédico | Adaptación a literatura biomédica. | Terminología biomédica, principalmente en los idiomas de su corpus. |
| SciBERT | BERT para textos científicos | Preentrenamiento con literatura científica y vocabulario especializado. | Minería de publicaciones científicas. |
| Longformer | Transformer para documentos extensos | Atención local por ventanas y atención global selectiva. | Documentos que exceden el límite clásico de 512 tokens. |
| XLM-R | RoBERTa multilingüe y translingüe | Preentrenamiento multilingüe a gran escala con MLM. | Clasificación y transferencia entre idiomas. |
| ModernBERT | Modernización del encoder BERT | Embeddings posicionales rotatorios, atención local/global alternada y optimizaciones de ejecución. | Encoders modernos, procesamiento extenso y casos de código o texto, según el checkpoint. |
RoBERTa frente a BERT
RoBERTa (Robustly Optimized BERT Pretraining Approach) conserva la idea central de un encoder bidireccional, pero demuestra que las decisiones de preentrenamiento tienen una influencia considerable. Incorpora máscaras dinámicas, secuencias más largas, entrenamiento prolongado y un tokenizador basado en BPE a nivel de bytes en sus modelos originales. No es correcto resumirlo como «BERT con más capas».
ALBERT frente a DistilBERT
ALBERT reduce la cantidad de parámetros únicos mediante factorización de embeddings y compartición de parámetros entre capas. DistilBERT, en cambio, comprime el modelo mediante destilación; su publicación reporta aproximadamente un 40 % menos de parámetros y una ejecución alrededor de un 60 % más rápida en las condiciones evaluadas, conservando cerca del 97 % del rendimiento de referencia. Son mecanismos de eficiencia distintos: menos parámetros no garantiza por sí solo menos operaciones ni latencia inferior.
ELECTRA y DeBERTaV3
ELECTRA cambia el problema autosupervisado: un generador propone sustituciones y un discriminador aprende a detectar qué posiciones fueron alteradas. Esta señal se aplica a muchas más posiciones que el MLM clásico. DeBERTaV3 adopta un preentrenamiento inspirado en ELECTRA, además de su arquitectura de atención desacoplada; por eso no debería describirse simplemente como otra versión con MLM.
ModernBERT y la cuestión del contexto largo
ModernBERT presenta una actualización del encoder con soporte para secuencias de hasta 8192 tokens en sus checkpoints publicados, embeddings posicionales rotatorios (RoPE) y capas de atención global intercaladas con atención local. Sus modelos de referencia Base y Large se publicaron con aproximadamente 149 y 395 millones de parámetros. Sin embargo, los checkpoints originales se entrenaron principalmente con fuentes en inglés y código: no deben considerarse automáticamente modelos optimizados para español.
BERT en español: BETO, MarIA, BERTIN y otros modelos disponibles
El idioma del conjunto de entrenamiento importa. Un modelo en inglés puede tokenizar texto español, pero eso no significa que sus representaciones estén bien adaptadas al idioma. Para sistemas de NLP en español conviene comparar un encoder monolingüe, un modelo multilingüe y, si existe, uno especializado en el dominio.
| Modelo | Arquitectura o enfoque | Checkpoint verificable | Aplicación orientativa |
|---|---|---|---|
| mBERT | BERT multilingüe, entrenado con Wikipedia en 104 idiomas | google-bert/bert-base-multilingual-cased | Baselines multilingües y transferencia entre idiomas. |
| BETO cased | BERT Base preentrenado en español con WWM; conserva mayúsculas | dccuchile/bert-base-spanish-wwm-cased | NER, clasificación y documentos con nombres propios. |
| BETO uncased | BERT Base en español con WWM; sin distinción de mayúsculas | dccuchile/bert-base-spanish-wwm-uncased | Clasificación general y comparación con BETO cased. |
| MarIA Base | RoBERTa entrenado en corpus de la Biblioteca Nacional de España | PlanTL-GOB-ES/roberta-base-bne | Procesamiento general de español. |
| MarIA Large | Variante de mayor capacidad de la familia RoBERTa BNE | PlanTL-GOB-ES/roberta-large-bne | Entornos con mayor disponibilidad de cómputo. |
| BERTIN | RoBERTa Base preentrenado desde cero sobre español de mC4 mediante muestreo basado en perplejidad | bertin-project/bertin-roberta-base-spanish | Comparativas de preentrenamiento y tareas en español. |
| RoBERTalex | RoBERTa especializado en textos jurídicos españoles | PlanTL-GOB-ES/RoBERTalex | Documentación normativa y jurídica. |
| RoBERTa biomédico ES | Encoder adaptado a vocabulario biomédico español | PlanTL-GOB-ES/roberta-base-biomedical-es | Clasificación y extracción biomédica. |
| Longformer BNE ES | Variante de la familia RoBERTa BNE para secuencias extensas | PlanTL-GOB-ES/longformer-base-4096-bne-es | Procesamiento de documentos largos. |
BETO: una implementación BERT especialmente relevante para español
BETO fue desarrollado por investigadores de la Universidad de Chile y ofrece versiones cased y uncased. Conserva el enfoque de BERT Base y utiliza enmascaramiento de palabras completas. Es un punto de partida razonable para realizar fine-tuning con documentos en español y para comparar con mBERT.
La elección entre BETO cased y uncased debe depender del conjunto de evaluación. Por ejemplo, en reconocimiento de organismos, personas y siglas, las mayúsculas pueden aportar información; en textos con normalización irregular, la variante uncased podría resultar competitiva.
MarIA y BERTIN: entrenamientos monolingües con estrategias diferentes
MarIA es una familia de modelos del proyecto español PlanTL, basada en RoBERTa, entrenada con un corpus de aproximadamente 570 GB de texto limpio y deduplicado preparado a partir de rastreos de la Biblioteca Nacional de España. La cifra corresponde al corpus preparado para la familia, no al tamaño en memoria de cada checkpoint.
BERTIN se basa también en RoBERTa, pero investiga una estrategia eficiente de selección de muestras usando estimaciones de perplejidad sobre la porción española de mC4. Su interés técnico reside tanto en el modelo resultante como en la metodología de preentrenamiento.
Variación regional y adaptación de dominio
«Entrenado en español» no equivale a «validado para todas las variantes del español». Si la aplicación procesa documentación argentina, expedientes administrativos, modismos rioplatenses, abreviaturas o nombres de organismos locales, hay que medir su comportamiento con un corpus representativo del dominio. La adaptación mediante DAPT y el entrenamiento supervisado con ejemplos locales pueden ser más útiles que sustituir automáticamente el encoder por otro de mayor tamaño.
Implementación de BERT en español con Python y Hugging Face
Ejemplo 1: inferencia con un modelo MLM preentrenado
El siguiente ejemplo carga BETO cased e infiere candidatos para una posición enmascarada. No requiere un conjunto de etiquetas, porque utiliza directamente el objetivo de preentrenamiento MLM.
pip install torch transformersfrom transformers import AutoTokenizer, AutoModelForMaskedLM, pipeline
checkpoint = "dccuchile/bert-base-spanish-wwm-cased"
tokenizer = AutoTokenizer.from_pretrained(checkpoint)
model = AutoModelForMaskedLM.from_pretrained(checkpoint)
completar = pipeline(
task="fill-mask",
model=model,
tokenizer=tokenizer
)
texto = f"El expediente fue enviado al {tokenizer.mask_token}."
for candidato in completar(texto, top_k=5):
print(candidato["token_str"], candidato["score"])El resultado es una distribución predictiva sobre tokens del vocabulario, no una verificación factual. La frase y el contexto condicionan las alternativas propuestas. El tokenizador debe corresponder al checkpoint: intercambiar tokenizadores entre familias puede introducir incompatibilidades de vocabulario y segmentación.
Ejemplo 2: fine-tuning supervisado para clasificación de documentos
Para un problema con tres categorías, supongamos dos archivos CSV (train.csv y validacion.csv) con columnas texto y etiqueta. La etiqueta debe estar codificada como entero 0, 1 o 2. El ejemplo es una base de entrenamiento reproducible; los datos, la definición de clases y la evaluación final deben adaptarse al caso concreto.
pip install torch transformers datasets accelerate scikit-learnimport numpy as np
from datasets import load_dataset
from sklearn.metrics import accuracy_score, f1_score
from transformers import (
AutoTokenizer,
AutoModelForSequenceClassification,
DataCollatorWithPadding,
Trainer,
TrainingArguments,
)
checkpoint = "dccuchile/bert-base-spanish-wwm-cased"
tokenizer = AutoTokenizer.from_pretrained(checkpoint)
datos = load_dataset(
"csv",
data_files={
"train": "train.csv",
"validation": "validacion.csv",
},
).rename_column("etiqueta", "labels")
def tokenizar(lote):
return tokenizer(lote["texto"], truncation=True, max_length=256)
datos = datos.map(tokenizar, batched=True)
modelo = AutoModelForSequenceClassification.from_pretrained(
checkpoint,
num_labels=3,
)
def metricas(prediccion):
pred = np.argmax(prediccion.predictions, axis=-1)
real = prediccion.label_ids
return {
"accuracy": accuracy_score(real, pred),
"f1_macro": f1_score(real, pred, average="macro"),
}
argumentos = TrainingArguments(
output_dir="./bert-es-clasificador",
learning_rate=2e-5,
per_device_train_batch_size=8,
per_device_eval_batch_size=8,
gradient_accumulation_steps=2,
num_train_epochs=3,
eval_strategy="epoch",
save_strategy="epoch",
seed=42,
report_to="none",
)
entrenador = Trainer(
model=modelo,
args=argumentos,
train_dataset=datos["train"],
eval_dataset=datos["validation"],
data_collator=DataCollatorWithPadding(tokenizer),
processing_class=tokenizer,
compute_metrics=metricas,
)
entrenador.train()
entrenador.save_model("./bert-es-clasificador/final")
tokenizer.save_pretrained("./bert-es-clasificador/final")La cabeza de clasificación se inicializa específicamente para la tarea. Por tanto, no deben interpretarse sus logits como predicciones fiables antes del entrenamiento. En experimentos reales conviene reservar un conjunto de prueba independiente, verificar desbalanceo entre clases y fijar las versiones de transformers, datasets y torch utilizadas, porque las interfaces de entrenamiento evolucionan.
Ejemplo 3: embeddings de tokens y uso correcto de la máscara de atención
Para acceder a las representaciones internas del encoder sin una cabeza supervisada, puede utilizarse AutoModel:
import torch
from transformers import AutoTokenizer, AutoModel

checkpoint = "dccuchile/bert-base-spanish-wwm-cased"
tok = AutoTokenizer.from_pretrained(checkpoint)
enc = AutoModel.from_pretrained(checkpoint).eval()

entradas = tok(
    ["El documento fue firmado.", "La resolución fue notificada."],
    padding=True,
    truncation=True,
    return_tensors="pt",
)

with torch.inference_mode():
    salida = enc(**entradas)

estados = salida.last_hidden_state
mascara = entradas["attention_mask"].unsqueeze(-1)
media = (estados * mascara).sum(dim=1) / mascara.sum(dim=1).clamp(min=1)

print(estados.shape)  # [lote, longitud, dimension_oculta]
print(media.shape)    # [lote, dimension_oculta]
Esta media ignora posiciones de relleno, pero no convierte a BETO en un modelo de embeddings semánticos optimizado. Para búsqueda por similitud, evaluar primero un encoder entrenado con pérdidas contrastivas, un cross-encoder para reordenamiento o una combinación híbrida de recuperación léxica y semántica.
Evaluación rigurosa, eficiencia y despliegue en producción
Diseño experimental y métricas
La selección de un checkpoint no debería depender de una única puntuación publicada. Para comparar BETO, MarIA, BERTIN o mBERT de forma reproducible, resulta conveniente:
- Crear divisiones de entrenamiento, validación y prueba sin fuga de información entre documentos casi duplicados, personas, expedientes o fuentes relacionadas.
- Establecer un baseline léxico o estadístico y un baseline basado en encoder multilingüe.
- Medir F1 macro y F1 por clase cuando existe desbalanceo; usar precisión y exhaustividad según el costo de falsos positivos y negativos.
- Para NER, evaluar coincidencia exacta de entidades y su tipo, además de métricas por token si aportan valor. Alinear las etiquetas con los subtokens; las posiciones ignoradas suelen usar
-100. - Para respuesta extractiva, registrar Exact Match y F1; para recuperación, métricas como
Recall@k,MRRonDCGcon juicios de relevancia. - Repetir semillas cuando corresponda, registrar intervalos de confianza y controlar el costo real por documento procesado.
Hiperparámetros y capacidad de contexto
Como punto de partida, el ajuste fino de encoders BERT suele explorarse con tasas de aprendizaje del orden de 2e-5 a 5e-5, lotes sujetos a la memoria disponible y varias épocas de entrenamiento. No son valores universalmente óptimos: longitud de secuencia, tamaño del corpus, regularización y estrategia de selección de checkpoints pueden alterar el resultado.
La ventana de 512 tokens obliga a definir qué hacer con expedientes y documentos extensos: truncamiento, división con solapamiento, agregación de predicciones por fragmento o modelos como Longformer. El tamaño final debe determinarse a partir de la distribución de longitudes después de tokenizar, no contando palabras.
Optimización de inferencia
- Batching dinámico: agrupar textos de longitud semejante y evitar relleno excesivo.
- Precisión reducida: evaluar FP16, BF16 o cuantización según hardware y tolerancia a la degradación.
- ONNX y runtimes optimizados: medir si la exportación mejora latencia y consumo en el servidor objetivo.
- Destilación: entrenar un modelo alumno para una tarea concreta cuando la latencia del modelo completo no es aceptable.
- Monitoreo: registrar latencias p50/p95, uso de memoria, distribución de confianza, deriva lingüística y rendimiento por tipo documental.
Privacidad, seguridad y gobernanza de datos
En sistemas que procesan información de personas, historias clínicas, contratos o documentos administrativos, el preprocesamiento debe incluir evaluación de datos personales y secretos. El uso de un modelo local no elimina la necesidad de controles de acceso, auditoría, retención de datos y pruebas de filtración. La anonimización y seudonimización pueden resultar útiles, pero sus garantías dependen del procedimiento y de la posibilidad de reidentificación.
Además, un modelo entrenado con un corpus público puede reflejar sesgos temporales, regionales y de representación. Deben documentarse licencia, procedencia del conjunto de entrenamiento y condiciones de uso del checkpoint específico.
BERT frente a GPT, los LLM generativos y el uso en motores de búsqueda
BERT es un encoder bidireccional diseñado para producir representaciones contextualizadas; GPT y otros modelos autorregresivos utilizan predominantemente decodificadores con atención causal para generar nuevos tokens. Ambos pertenecen al ecosistema Transformer, pero difieren en objetivo de entrenamiento, arquitectura y propiedades de inferencia.
Un encoder BERT es especialmente apropiado como componente de clasificadores, extractores, filtros, recuperadores o reordenadores. Un LLM generativo puede redactar o resumir respuestas, aunque con costos distintos y riesgos de generación no sustentada. En arquitecturas de retrieval-augmented generation (RAG), ambos tipos pueden convivir: un sistema recupera evidencia con embeddings y filtros, reordena fragmentos con un encoder y genera una respuesta con un decodificador.
Google también utilizó el nombre BERT para explicar mejoras en la interpretación de consultas en su buscador. Eso no implica que exista una fórmula de SEO específica de BERT ni que repetir palabras clave ayude a «optimizar para BERT». Para contenidos técnicos, es preferible describir entidades, términos y relaciones con precisión, resolver la intención de búsqueda y enlazar fuentes primarias verificables.
Preguntas frecuentes sobre BERT
¿Qué significa BERT en español?
Significa Bidirectional Encoder Representations from Transformers: «representaciones de codificadores bidireccionales basadas en transformadores». Es el nombre de una arquitectura de representación de lenguaje, no un traductor automático.
¿Cuál es la diferencia entre BERT y BETO?
BERT designa la arquitectura y los modelos originales; BETO es una implementación BERT Base preentrenada específicamente con texto español y enmascaramiento de palabras completas. BETO no es el resultado de traducir palabra por palabra un checkpoint en inglés.
¿Qué modelo es mejor para español: BETO, MarIA o BERTIN?
No existe un ganador universal. BETO, MarIA y BERTIN se basan en estrategias y corpus diferentes. La elección depende de la tarea, el español utilizado, el tamaño del conjunto etiquetado, la longitud de los documentos y las restricciones de inferencia. La respuesta debe derivarse de una evaluación controlada sobre datos representativos.
¿BERT puede generar texto como ChatGPT?
El BERT original no está diseñado para generación autorregresiva abierta. Puede reconstruir tokens enmascarados o actuar como encoder en arquitecturas más complejas, pero no reemplaza directamente a un modelo generativo conversacional.
¿Es posible usar BERT para detectar DNI, nombres o datos personales?
Sí. Un encoder BERT con cabeza de clasificación por token puede entrenarse para reconocer entidades sensibles. Sin embargo, para anonimización documental conviene combinarlo con reglas, validadores específicos, revisión de falsos negativos y controles que garanticen que la información también se elimina del archivo exportado y de sus metadatos.
¿Qué alternativa existe para textos superiores a 512 tokens?
Se puede dividir el texto en fragmentos con solapamiento o utilizar encoders de contexto largo. Para español existe, por ejemplo, PlanTL-GOB-ES/longformer-base-4096-bne-es. La capacidad anunciada no evita evaluar el uso de memoria y la calidad sobre documentos reales.
Conclusión
BERT sigue siendo un punto de referencia esencial para comprender los encoders Transformer. Su principal aporte fue demostrar que el preentrenamiento bidireccional profundo permite transferir representaciones del lenguaje a numerosas tareas mediante ajuste fino. Las variantes posteriores optimizaron el enmascaramiento, el uso de parámetros, la eficiencia del entrenamiento y la gestión del contexto largo.
Para proyectos técnicos en español, la decisión más sólida no es elegir automáticamente el modelo más grande, sino comparar mBERT, BETO, MarIA, BERTIN y alternativas especializadas bajo el mismo protocolo de evaluación, contemplando calidad, latencia, costo operativo, privacidad y variación regional del idioma.
Referencias científicas y documentación oficial
- Devlin et al. (2018/2019). BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding.
- Liu et al. (2019). RoBERTa: A Robustly Optimized BERT Pretraining Approach.
- Lan et al. (2019). ALBERT: A Lite BERT for Self-supervised Learning of Language Representations.
- Sanh et al. (2019). DistilBERT, a distilled version of BERT.
- Clark et al. (2020). ELECTRA: Pre-training Text Encoders as Discriminators Rather Than Generators.
- He et al. (2020). DeBERTa: Decoding-enhanced BERT with Disentangled Attention.
- He et al. (2021). DeBERTaV3: Improving DeBERTa using ELECTRA-Style Pre-Training.
- Joshi et al. (2020). SpanBERT: Improving Pre-training by Representing and Predicting Spans.
- Conneau et al. (2020). Unsupervised Cross-lingual Representation Learning at Scale (XLM-R).
- Proyecto BETO, Universidad de Chile. Repositorio y checkpoints para español.
- PlanTL / BSC. Modelos MarIA, BNE y recursos en español.
- Proyecto BERTIN. Modelo y referencias científicas.
- Hugging Face. ModernBERT: modernización de encoders Transformer.
- Hugging Face. Documentación de Transformers.


